영수증 2만 장을 다시 열어봤다 — 없는 줄 알았던 컬럼과, 9시간 틀린 그래프
커피콩 앱에 3개월 반 동안 쌓인 카페 영수증 17,504장을 열어봤다. 컬럼에 없는 줄 알았던 매장명이 살아있었고, 시간대 그래프는 9시간 틀려 있었으며, "전국 카페 12,780곳"이라는 틀린 숫자를 발행 직전에 잡았다.
커피콩에는 카페 영수증을 찍으면 원두를 주는 기능이 있다. 결제액의 10%, 최대 500원두, 하루 한 장. 원두 10개가 1원이니까 한 장에 최대 50원이다.
기능을 만들 때 우리가 한 일은 딱 거기까지였다. 영수증을 받고, 금액을 읽고, 원두를 주고, 끝. 그렇게 3개월 반이 지났고 2만 장이 쌓였다. 이걸로 뭘 할 수 있나 싶어서 열어봤는데, 세 가지가 나왔다. 하나는 반가웠고, 하나는 뜨끔했고, 하나는 하마터면 거짓말을 할 뻔했다.
1. 매장명은 컬럼에 없었다. 그런데 살아있었다.
테이블을 열자마자 실망했다. brand는 있는데 store가 없다. 브랜드는 스타벅스·커피빈·메가커피·이디야·기타 다섯 값짜리 고정 목록이라, 동네 카페는 전부 기타로 뭉개진다. 실제로 승인된 17,504건 중 10,331건, 59%가 기타다.
절반 넘는 데이터가 "어딘가의 카페"라는 뜻이다. 지도에 못 올리고, 가격 비교도 못 하고, 아무것도 못 한다.
그러다 ocrRaw 컬럼을 봤다. 이름만 보고 원본 텍스트겠거니 했는데, 열어보니 이랬다.
[
  {
    "brand": "기타",
    "store": "봄비 Roasters",
    "total": 13500,
    "paidAmount": 13500,
    "discountAmount": 0,
    "hasDiscount": false,
    "paidAt": "2026-08-05 11:48",
    "approvalNo": "14502792",
    "isPaymentReceipt": true,
    "imageQuality": "clear",
    "confidence": 0.95
  }
]
OCR에 쓴 LLM의 JSON 응답을 통째로 넣어둔 거였다. 그리고 거기 store가 있었다. 우리가 컬럼으로 안 뽑았을 뿐, 3개월 내내 저장되고 있었다.
전체 ocrRaw 보유:     20,814건
store 키 존재:        20,814건 (100%)
정규식 파싱 성공:      20,037건 (96.3%)
봄비 Roasters, 우지커피 시흥정왕점, 빌리엔젤 압구정역점, 카페 깜장콩, DDC 돌담커피 용산점, 고려대 SK미래관 1847카페… 비전 API를 다시 부를 필요도 없다. UPDATE ... SET store = substring(...) 한 방이면 된다.
교훈이라기엔 민망하지만: 파싱 결과를 버릴 때 원본 응답은 남겨둬라. 우리가 잘해서가 아니라 그냥 디버깅용으로 넣어둔 컬럼이 3개월치 데이터를 살렸다.
2. 사람들은 새벽 3시에 커피를 마시지 않는다
매장명을 건졌으니 다음은 시간대였다. 언제 커피를 사는지 보려고 한 줄 짰다.
SELECT extract(hour from "ocrPaidAt") h, count(*)
FROM coffeecong_cafe_receipt GROUP BY h ORDER BY h;
결과가 이상했다.
 3시 │ ████████████████████ 2,176   ← 피크
 4시 │ █████████████████ 1,926
 5시 │ ██████████████ 1,619
 ...
14시 │ 28
17시 │ 4
새벽 3시가 피크고 오후 5시가 4건. 커피를 새벽에 마시고 오후엔 안 마시는 나라는 없다.
ocrPaidAt의 타입은 timestamp without time zone이다. 타임존 정보가 없다. 그래서 처음엔 "저장이 깨졌구나" 싶었는데, 확인해보니 아니었다.
제출 지연(createdAt - ocrPaidAt)을 재봤다. p10이 4분이었다. 결제하고 4분 만에 찍어 올린 사람들이다. 두 컬럼이 같은 기준이 아니면 나올 수 없는 값이고, Prisma는 timestamp without time zone을 UTC로 저장한다. 즉 저장은 멀쩡했다.
틀린 건 읽는 쪽이었다. UTC 3시는 KST 정오다. +9를 하면 이렇게 된다.
KST 12시 │ ████████████████████ 2,176   ← 점심 먹고 커피
KST 13시 │ █████████████████ 1,926
KST 09시 │ █████████████ 1,454          ← 출근길
KST 08시 │ ██████████ 1,151
KST 03시 │ ▏19
점심 직후가 최대 피크, 오전 8~9시에 출근길 봉우리, 새벽엔 사실상 0. 누구나 아는 한국인의 커피 패턴이 그제야 나왔다.
timestamp without time zone은 틀린 값을 주지 않는다. 틀릴 자유를 줄 뿐이다. 컬럼 이름에도, 타입에도 "이건 UTC야"라고 쓰여 있지 않으니 다음 사람도 똑같이 당한다. 우리 코드베이스엔 이미 같은 계열의 버그가 한 번 있었다 — 브랜드 혜택의 요일 비트마스크를 KST 기준으로 계산해야 하는데 UTC로 계산해서 9시간 밀렸던 적이 있고, 그 주석이 아직 남아 있다. 같은 함정을 두 번 밟은 셈이다.
3. "전국 카페 12,780곳" — 쓸 뻔했다
store를 파싱했더니 고유값이 12,780개 나왔다. 전국 카페 12,780곳의 실제 결제 데이터. 네이버에도 카카오에도 없는 데이터다. 여기까지 쓰고 발행할 뻔했다.
상위 매장을 눈으로 보다가 멈췄다.
| 매장명 | 건수 | 중앙 결제액 |
|---|---|---|
| 구의DT점 | 36 | ₩5,150 |
| 요거프레소 의정부행복로점 | 35 | ₩3,500 |
| 마산회원DT점 | 34 | ₩12,050 |
| 우지커피 시흥정왕점 | 34 | ₩2,000 |
| 마리오아울렛점 | 33 | ₩5,500 |
| 사이렌오더 | 30 | ₩11,650 |
구의DT점. 마산회원DT점. 사이렌오더.
DT는 드라이브스루고, 사이렌오더는 스타벅스 주문 시스템 이름이다. 중앙값도 11,000~12,000원대로 스타벅스 가격대다. 전부 스타벅스인데 OCR이 브랜드 접두어를 못 잡아서 따로 세어진 거다. 스타벅스 김포이마트점처럼 제대로 잡힌 것도 있으니, 같은 매장이 여러 이름으로 흩어져 있다.
그러니까 12,780은 매장 수가 아니라 정규화 전 문자열 종류 수, 즉 상한선이다. 진짜 매장 수는 이보다 한참 적다. 하마터면 우리 도메인에 틀린 숫자를 박아놓을 뻔했다.
그래서 데이터가 뭘 말하나
위 세 개를 정리하고 나서 남은, 믿을 만한 숫자들이다. 2026년 5월 2일부터 8월 13일까지, 승인된 영수증 17,504장, 기기 약 1,500대 기준이다.
브랜드별 결제액과 할인 사용률
| 브랜드 | 건수 | 중앙 결제액 | 할인 사용률 | 평균 할인액 |
|---|---|---|---|---|
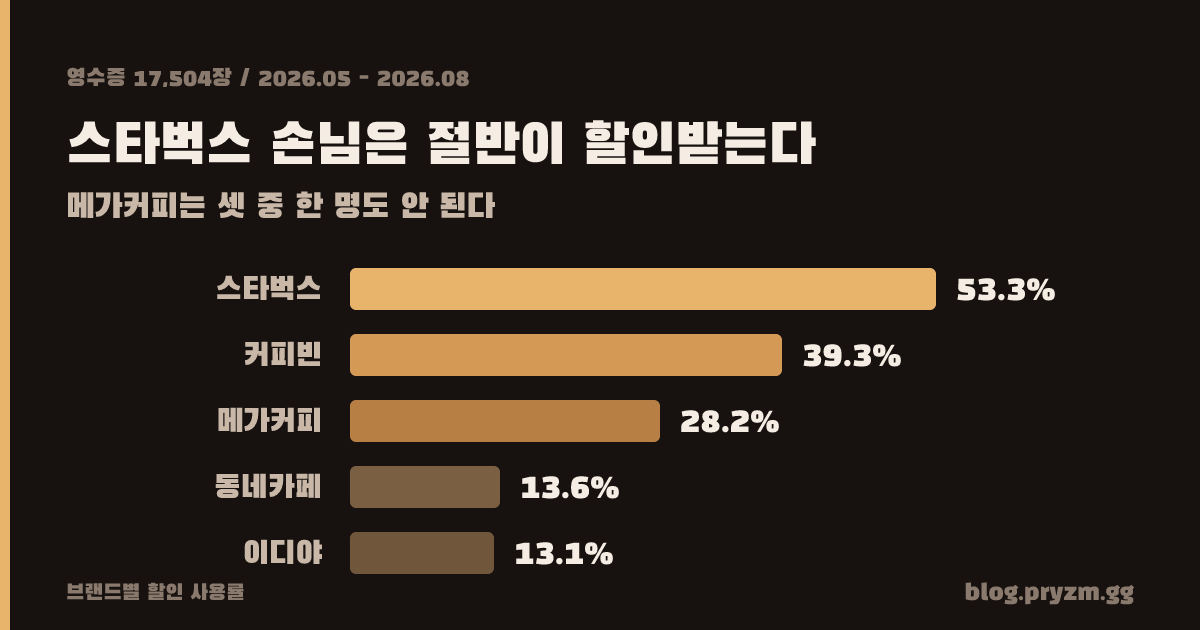
| 스타벅스 | 2,016 | ₩9,195 | 53.3% | ₩4,607 |
| 커피빈 | 151 | ₩10,000 | 39.3% | ₩2,193 |
| 메가커피 | 4,238 | ₩3,900 | 28.2% | ₩2,553 |
| 기타(동네카페) | 10,331 | ₩5,500 | 13.6% | ₩3,639 |
| 이디야 | 509 | ₩6,900 | 13.1% | ₩3,064 |
가장 눈에 띄는 건 할인 사용률 격차다. 스타벅스 손님은 절반 이상이 할인을 받고 나오는데, 메가커피는 셋 중 한 명도 안 된다. 이디야는 여덟 명 중 한 명 꼴이다.
역설적이다. 저가 브랜드에 가는 사람일수록 가격에 민감할 것 같은데, 할인은 덜 쓴다. 그럴 만도 한 게, 스타벅스는 별·사이렌오더·기프티콘처럼 할인 경로가 앱 안에 다 들어와 있고, 메가커피의 통신사 할인은 계산대에서 먼저 말을 꺼내야 한다. 마찰의 차이지 의지의 차이가 아닌 것 같다.
메가커피 평균 할인액이 ₩2,553인데 중앙 결제액이 ₩3,900이다. 할인을 쓴 사람과 안 쓴 사람이 같은 걸 사고 거의 두 배 차이 나는 돈을 내고 있다는 뜻이다.
언제 사는가 (KST)
08시 │ ██████████ 1,151
09시 │ █████████████ 1,454
10시 │ ███████████ 1,228
11시 │ ███████████ 1,263
12시 │ ████████████████████ 2,176
13시 │ █████████████████ 1,926
14시 │ ██████████████ 1,619
15시 │ ████████████ 1,377
16시 │ ██████████ 1,147
17시 │ ███████ 845
점심 직후 12~14시에 전체의 32%가 몰린다. 출근길(8~9시)이 두 번째 봉우리다. 저녁 이후로는 완만하게 떨어지고, 새벽 1~6시는 다 합쳐 100건이 안 된다.
영수증을 언제 찍는가
이건 우리 기능에 대한 데이터다. 결제부터 제출까지 중앙값 6.6시간, 상위 10%는 4분 안에 찍고, 하위 10%는 6일이 지나서 올린다.
하루 한 장 제한 때문에 사람들이 영수증을 모아뒀다가 나눠 올리는 것으로 보인다. 제한이 행동을 만들고 있다는 뜻인데, 이건 나쁘게 볼 일만은 아니라 좀 더 봐야겠다.
이 숫자를 읽을 때 주의할 것
발행하면서 스스로에게 건 제약들이다. 이거 빼고 인용되면 곤란하다.
- 중앙값은 객단가지 한 잔 값이 아니다. 스타벅스 ₩9,195는 아메리카노 가격이 아니라 한 번 결제에 쓴 돈이고, 두 잔 이상일 가능성이 높다. 우리 OCR은 품목을 읽지 않는다. 그래서 "아메리카노 얼마"는 이 데이터로 말할 수 없다.
- 날짜의 6%가 OCR 오독이다. 2026년이 19,156건인데 2020년이 848건, 2016년이 34건, 심지어 2028년(미래)이 30건 있다. 위 집계는 2026년만 쓴 게 아니라 전체 기준이라 이 노이즈가 섞여 있다.
- 표본이 편향돼 있다. 원두를 받으려고 영수증을 찍는 사람들이다. 커피에 돈을 쓰고 그걸 아까워하는 인구의 표본이지, 전 국민 표본이 아니다.
- 매장 수는 말하지 않는다. 위에 쓴 이유로 정규화 전이다.
다음
ocrRaw → store백필. 한 번이면 되고 비전 API 비용은 0원이다.- 매장명 정규화.
사이렌오더·○○DT점을 스타벅스로 접는 규칙부터. - OCR 프롬프트에
items[]추가. 과거는 못 살리지만 앞으로는 품목별 가격이 쌓인다. 그게 되면 "아메리카노 실거래가"를 처음으로 말할 수 있다. ocrPaidAt을 쓰는 모든 집계에 KST 변환을 강제하는 헬퍼 하나. 세 번째로 밟기 전에.
가장 크게 배운 건 따로 있다. 우리는 이 데이터를 3개월 동안 원두 주는 근거로만 썼다. 한 장에 50원짜리로 취급했는데, 열어보니 그 안에 전국 카페의 실제 결제 기록이 들어 있었다.
데이터는 쌓는 순간이 아니라 열어보는 순간에 생긴다.